打造知识库
1 流程
- word、ppt 转换为 txt,或者直接收集 txt、markdown 等文本
- 进入GPU服务器,利用
make_dataset(prepare_dataset)制作问答对 - 利用
import2fastgpt把原始文本和问答对导入 fastgpt,同时这个代码会把长文本切片,并对切片的文本生成摘要再导入 fastgpt - (可选)可以利用
import2fastgpt定期导入爬取的 url 内容。
2 安装
2.1 make_dataset
cd /home
git clone https://github.com/pharaohnie/make_dataset
cd make_dataset
virtualenv .venv
source .venv/bin/activate
pip install -r requirements.txt
apt install libreoffice-core libreoffice-writer
2.2 import2fastgpt
cd /home
git clone https://github.com/pharaohnie/import2fastgpt
cd import2fastgpt
virtualenv .venv
source .venv/bin/activate
pip install -r requirements.txt
3 准备文本库
需要将pdf、docx 等文件保存为 txt
3.1 方法 1
直接参考并运行 4. 制作问答对 中的 office2txt.py
3.2 方法 2
参考 doc2x 进行 ocr
4 制作问答对
4.1 目录结构
make_dataset/
├── book                # office2txt.py 运行后的 txt 文本保存在这里
├── docs                # 需要转换的 office 文件放到这里
│   └── done            # 转换成功的 office 文件会自动易懂到这里
├── output              # 最终生成的 jsonl 文件保存在这里
├── saveChunk           # 切片后的长文本保存在这里
├── .env                # 配置文件
├── make_dataset.py     # 制作问答对的 py 程序
├── office2txt.py       # office 转 txt 的 py 程序
├── README
├── run.sh              # 一次性运行 split.py 和 make_dataset.py
└── split.py            # 切割长文本的 py 程序
4.2 配置 .env
# 文本路径
INPUT_FILE_PATH=./book


BASE_URL=http://10.0.1.125:30004/v1
API_KEY=sk-xxx
MODEL=Qwen/Qwen2-72B-Instruct-AWQ

# 每个分段中提取问题的数量
ENTRIES_PER_FILE=6
4.3 运行
先把 office 的文件放到 ./docs 目录中,运行 python office2txt.py,这一步会把 office 格式的文件转换成 .txt 放到 ./book/ 目录
再运行 ./run.sh,生成的 jsonl 文件会都保存在 output目录中。
程序会用如何看待、分析、比较、解释、评价、为什么 这几种方式提问生成问答对。下面是运行日志的示例:
2024-08-15 09:27:16,401 - INFO - 当前处理文件: ./saveChunk/20240703安全技能考核_00002.txt。生成第 1/6 个条目
2024-08-15 09:27:16,401 - INFO - 使用的指令类型: 如何看待
2024-08-15 09:27:22,770 - INFO - HTTP Request: POST http://10.0.1.125:30004/v1/chat/completions "HTTP/1.1 200 OK"
2024-08-15 09:27:22,776 - INFO - API 响应: {
    "instruction": "如何看待手提干粉灭火器在使用时必须竖立使用的这一要求?",
    "input": "",
    "output": "手提干粉灭火器在设计时考虑了干粉物质的特性,它们在灭火器内部是松散的粉末,必须在重力作用下向下流动以到达喷口。如果灭火器不是竖立使用,干粉可能无法正确流动,导致灭火效率降低, 甚至无法喷射。因此,这一要求是基于安全和有效灭火的考虑,确保灭火器在紧急情况下能发挥最大功效。"
}
2024-08-15 09:27:22,776 - INFO - 成功生成完整条目
5 导入 fastgpt
5.1 创建 fastgpt 集合
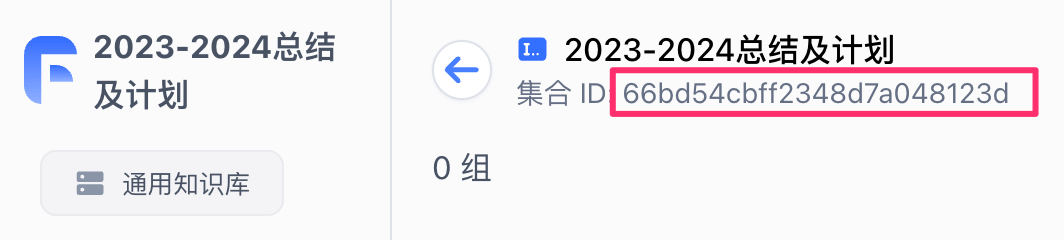
先在 fastgpt 中创建一个知识库,并在知识库中创建一个手动数据集,并记录 集合 ID
5.2 目录结构
import2fastgpt/
├── AUTO/                                       # 自动爬取网站 url 的脚本集合
│   ├── dangjian.sh*
│   ├── jiaowei-qitaxingzhengwenjian.sh*
│   ├── jiaowei-xingzhengguifanxingwenjian.sh*
│   ├── jiaowei-xinwen.sh*
│   ├── jiaoyubu-xinwen.sh*
│   └── jiaoyubu-zhengcejiedu.sh*
├── COLLECTION/                                 # 里面是 fastgpt 的集合 id 的 txt 文件,保存了哪些文件已经入库
├── FILE/                                       # 需要导入 fastgpt 的问答对或文件放到这个目录下
├── add_file_to_collection.sh*                  # 导入文本文件的脚本
├── add_qa.py                                   # 导入问答对的 py 文件
├── add_qa_to_collection.sh*                    # 导入问答对的脚本
├── app.py                                      # 导入 url 内容的 py 文件
├── collection.txt                              # 集合配置文件
├── crawl_jiaowei.py                            # 对应不同网站爬取 url 的 py 文件
├── crawl_jiaoyubu.py
├── crawl_qiushi.py
├── crawl_renminwang.py
├── .env                                        # 配置文件
├── import.sh*                                  # 导入 url 的脚本
└── README
5.3 配置 .env
# 文档切分长度
MAX_LENGTH=700

# fastgpt的url和key
API_BASE=http://localhost:30003/api
API_KEY=fastgpt-pI6IMsMvDx5JD63V5dLpf7T8mWnXsBMsdrJ0uXb1McnVPY8XaTxXrpeC

# oneapi的url和key,用于提取摘要,默认使用了 Qwen/Qwen2-72B-Instruct-AWQ
KEYWORD_API_URL=http://xxxxx/v1/chat/completions
KEYWORD_API_KEY=xxxxx

# 设置提取的摘要不超过多少字
KEYWORD_NUMBER=20
5.4 导入问答对
把 make_dataset 生成的 jsonl 文件复制到 FIlE/ 目录。
编辑 collection.txt 新增一行,如下
-------------------------+--------+-----------------
COLLECTION_ID            |  分类  | 子类
-------------------------+--------+-----------------
66bc9dbaff2348d7a047355e   三小     会议纪要-问答
!!! 结尾必须包含“-问答"
开始导入问答对
```bash
./add_qa_to_collection.sh 66bc9dbaff2348d7a047355e
5.5 导入原始文本
把 office2txt 生成的 txt 文件复制到 FIlE/ 目录。
编辑 collection.txt 新增一行,如下
-------------------------+--------+-----------------
COLLECTION_ID            |  分类  | 子类
-------------------------+--------+-----------------
66bc9dbaff2348d7a047355e   三小     会议纪要
开始导入原始文本
./add_file_to_collection.sh 66bc9dbaff2348d7a047355e
6 自动定期爬取导入 fastgpt
6.1 编写爬取 url 的 py 脚本
可以利用 chatgpt 编写,如果没有复杂的 js,用 BeautifulSoup4,如果有复杂 js,用 playwright。只要能输出 url 就可以,例如
python crawl_jiaowei.py https://jw.beijing.gov.cn/jyzx/jyxw
https://mp.weixin.qq.com/s/4cVEnCb1aKt5S75ehh-A2g
https://mp.weixin.qq.com/s/zkWKWPmz60v7NBo1UtjpoA
https://jw.beijing.gov.cn/jyzx/jyxw/202407/t20240724_3758218.html
https://jw.beijing.gov.cn/jyzx/jyxw/202407/t20240718_3752230.html
https://jw.beijing.gov.cn/jyzx/jyxw/202407/t20240718_3752338.html
https://jw.beijing.gov.cn/jyzx/jyxw/202407/t20240711_3743650.html
https://jw.beijing.gov.cn/jyzx/jyxw/202407/t20240709_3741366.html
https://jw.beijing.gov.cn/jyzx/jyxw/202407/t20240703_3736953.html
https://jw.beijing.gov.cn/jyzx/jyxw/202406/t20240624_3724328.html
https://jw.beijing.gov.cn/jyzx/jyxw/202406/t20240618_3718893.html
https://jw.beijing.gov.cn/jyzx/jyxw/202406/t20240606_3706681.html
https://jw.beijing.gov.cn/jyzx/jyxw/202406/t20240606_3706239.html
https://jw.beijing.gov.cn/jyzx/jyxw/202406/t20240604_3703837.html
https://jw.beijing.gov.cn/jyzx/jyxw/202405/t20240529_3698034.html
https://jw.beijing.gov.cn/jyzx/jyxw/202405/t20240529_3697799.html
https://jw.beijing.gov.cn/jyzx/jyxw/202405/t20240524_3693504.html
https://mp.weixin.qq.com/s/lQ4khzi-QMsuJ1Uphx05dg
https://jw.beijing.gov.cn/jyzx/jyxw/202405/t20240511_3674429.html
https://jw.beijing.gov.cn/jyzx/jyxw/202404/t20240429_3647128.html
https://jw.beijing.gov.cn/jyzx/jyxw/202404/t20240418_3621583.html
6.2 编写自动运行脚本
例如,AUTO/jiaowei-xinwein.sh
#!/bin/bash

COLLECTION="668254a26da25297e7d94b78"          # 定义 fastgpt 中的集合 ID
URL="https://jw.beijing.gov.cn/jyzx/jyxw"      # 教委新闻的链接

cd /home/import
source venv/bin/activate

python crawl_jiaowei.py "${URL}" > ./COLLECTION/${COLLECTION}.txt    # 把爬取的 url 放入到 {collection}.txt
python app.py ${COLLECTION}                    # 导入fastgpt
6.3 加入 crontab
40 2 * * * root /home/import/AUTO/jiaowei-xinwen.sh