RVC 唱歌训练
1 安装
git clone https://github.com/RVC-Project/Retrieval-based-Voice-Conversion-WebUI
cd etrieval-based-Voice-Conversion-WebUI
conda create -n rvc python=3.10
conda activate rvc
pip install --upgrade pip
pip install torch torchvision torchaudio
pip install -r requirements.txt

cd tools
./dlmodel.sh  #重复运行,直到所有模型下完
mv assets/* ../assets
2 运行
run.sh
#!/bin/bash
export CUDA_VISIBLE_DEVICES=0
source /root/miniconda3/bin/activate rvc
cd /home/Retrieval-based-Voice-Conversion-WebUI
python infer-web.py
3 训练数据准备
按照 GPT-SoVITS 训练 中的 3-6 步完成声音训练集的提取。
把提取出来的 wav 文件放到 ./data 中
4 训练
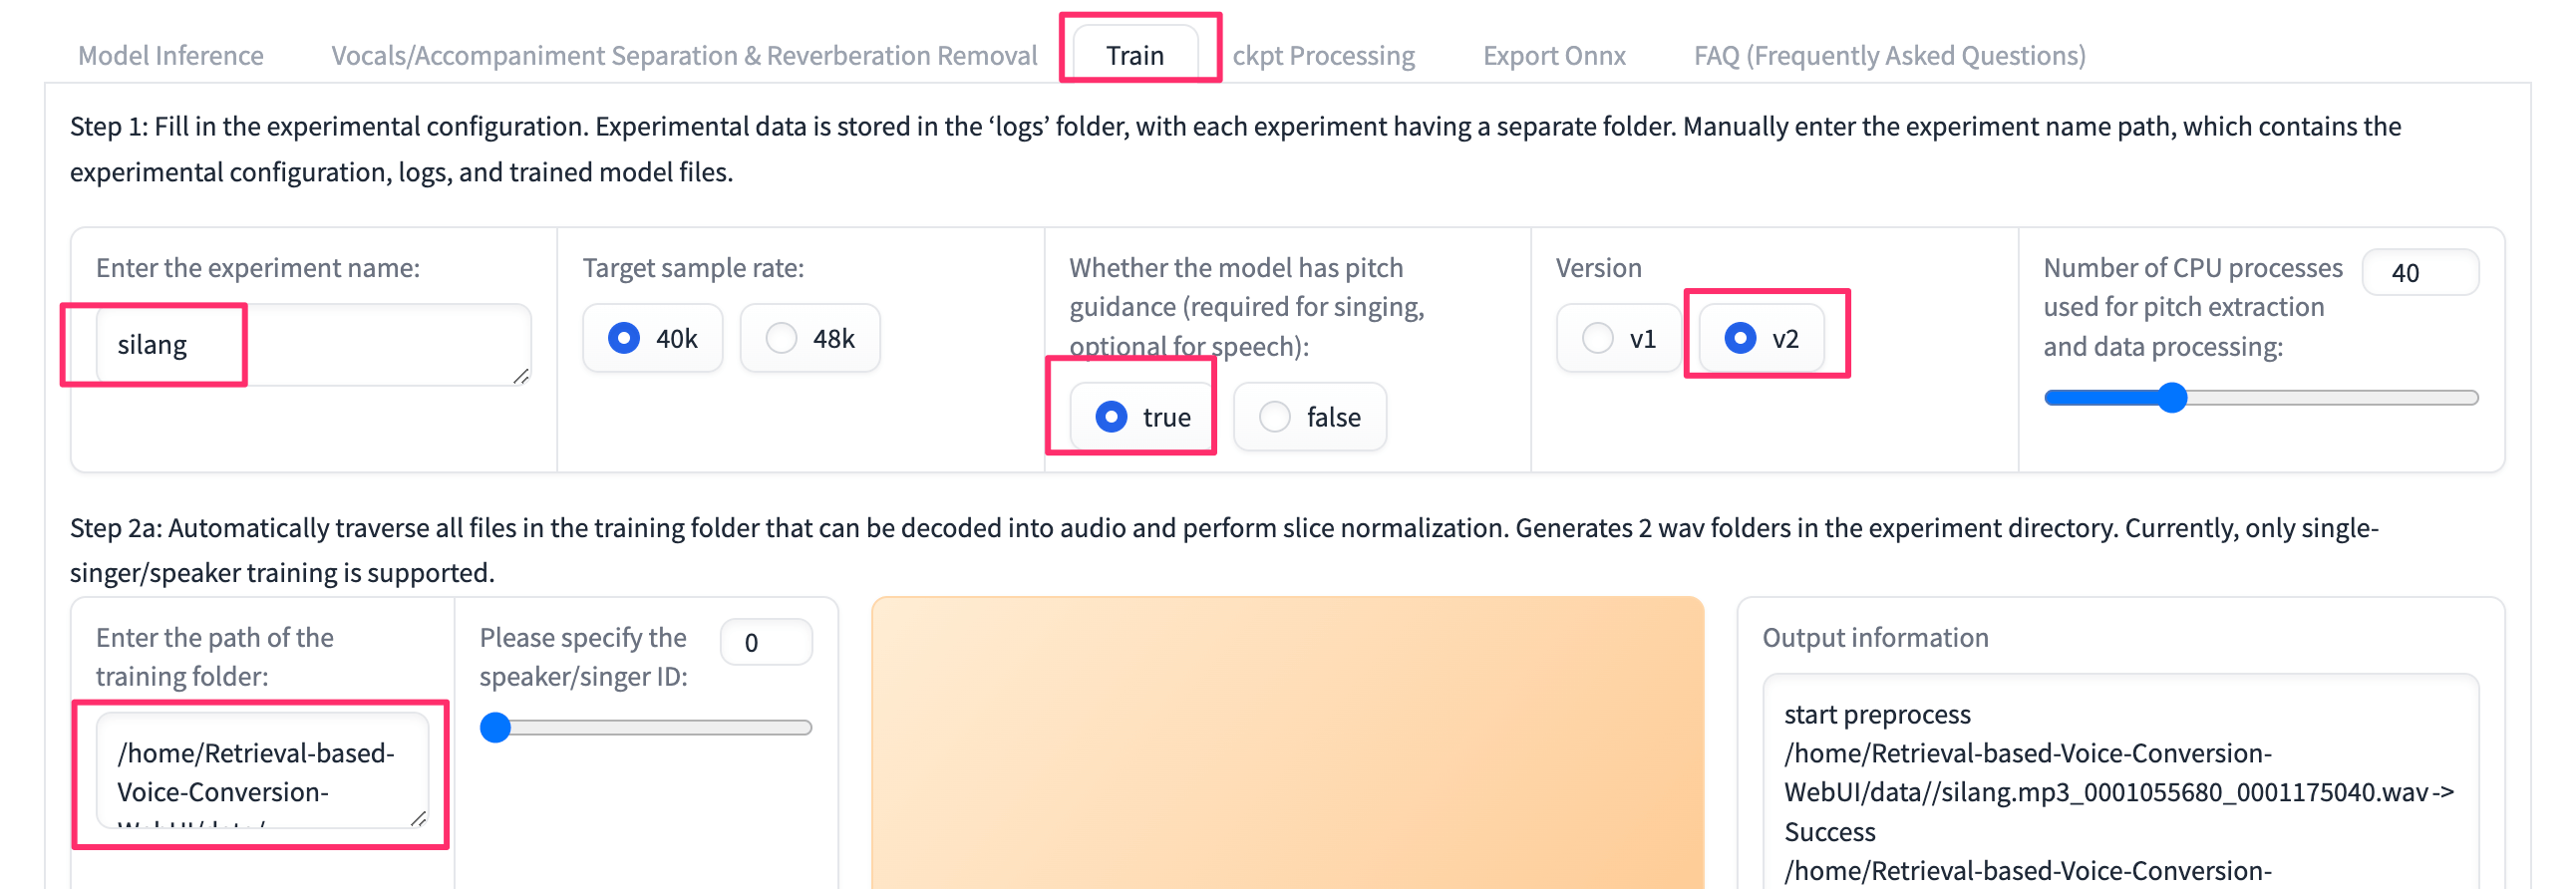
- 设置模型名称
- 数据路径设置为
/home/Retrieval-based-Voice-Conversion-WebUI/data/ - 点击
Process data
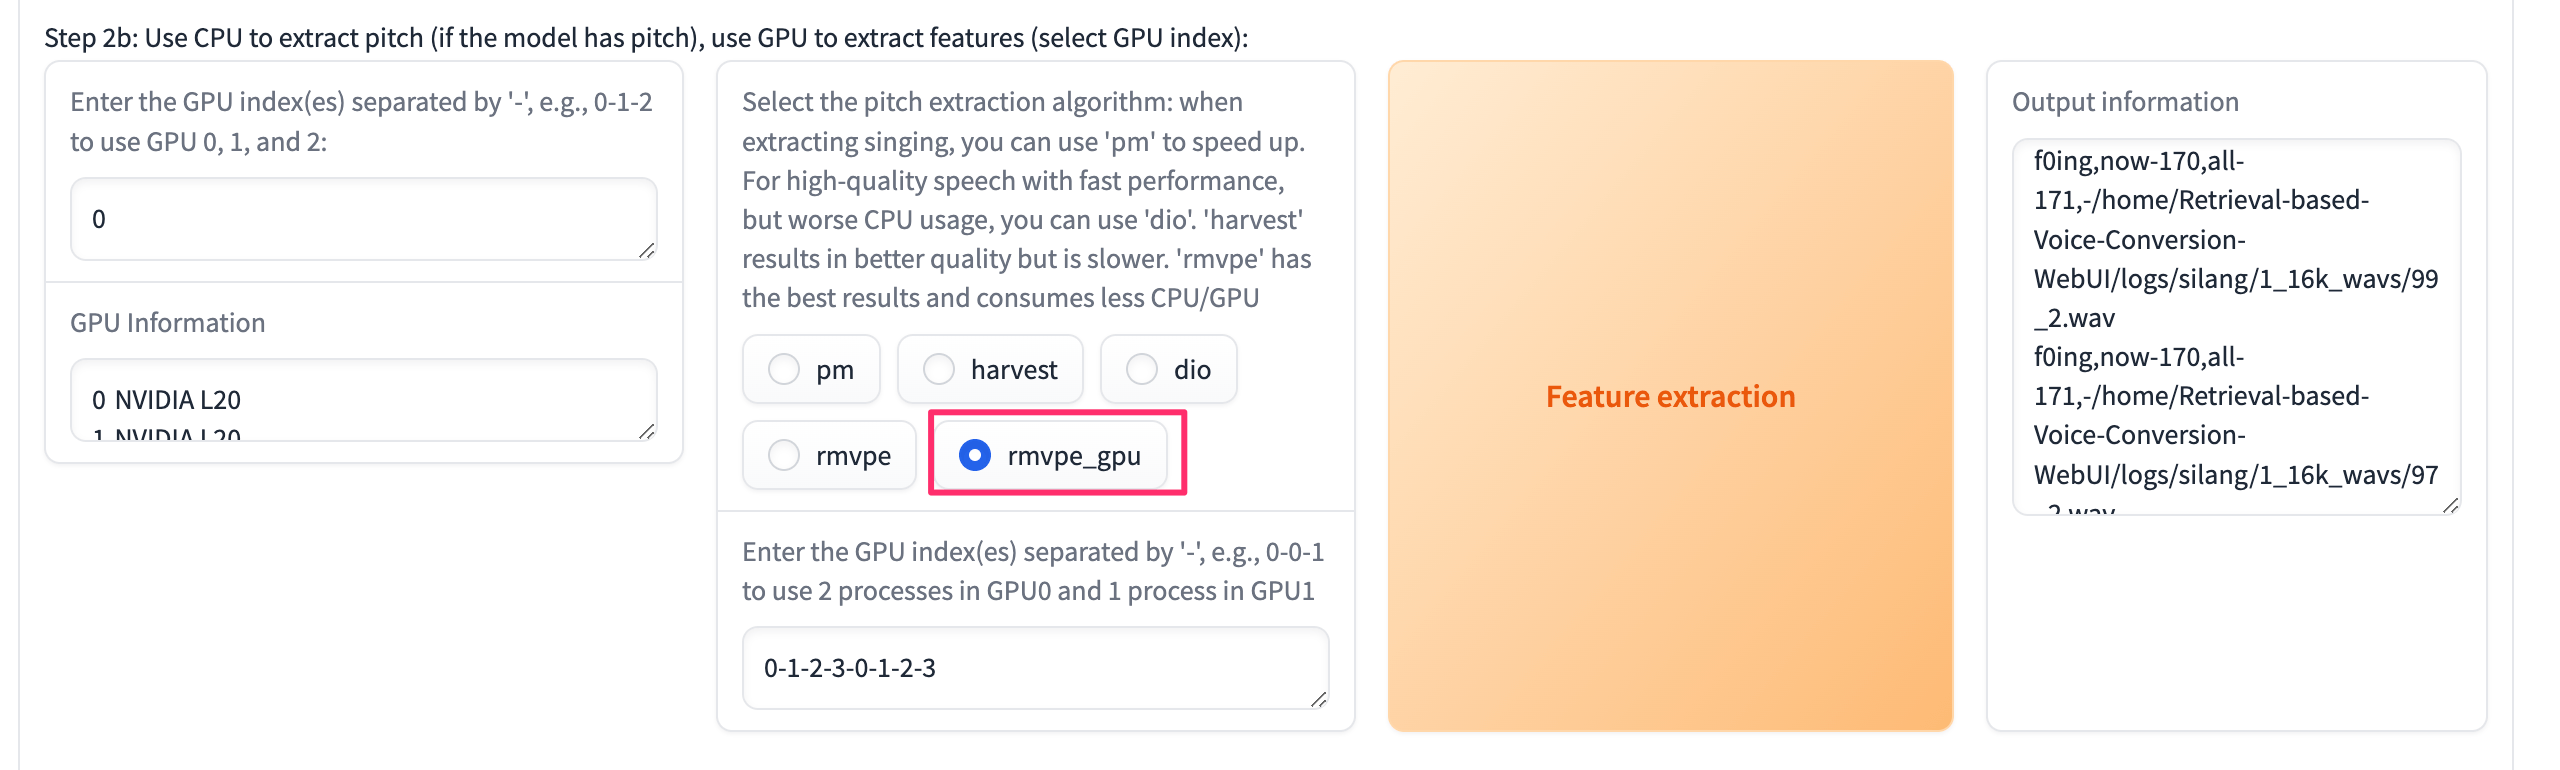
点击 Feature extraction
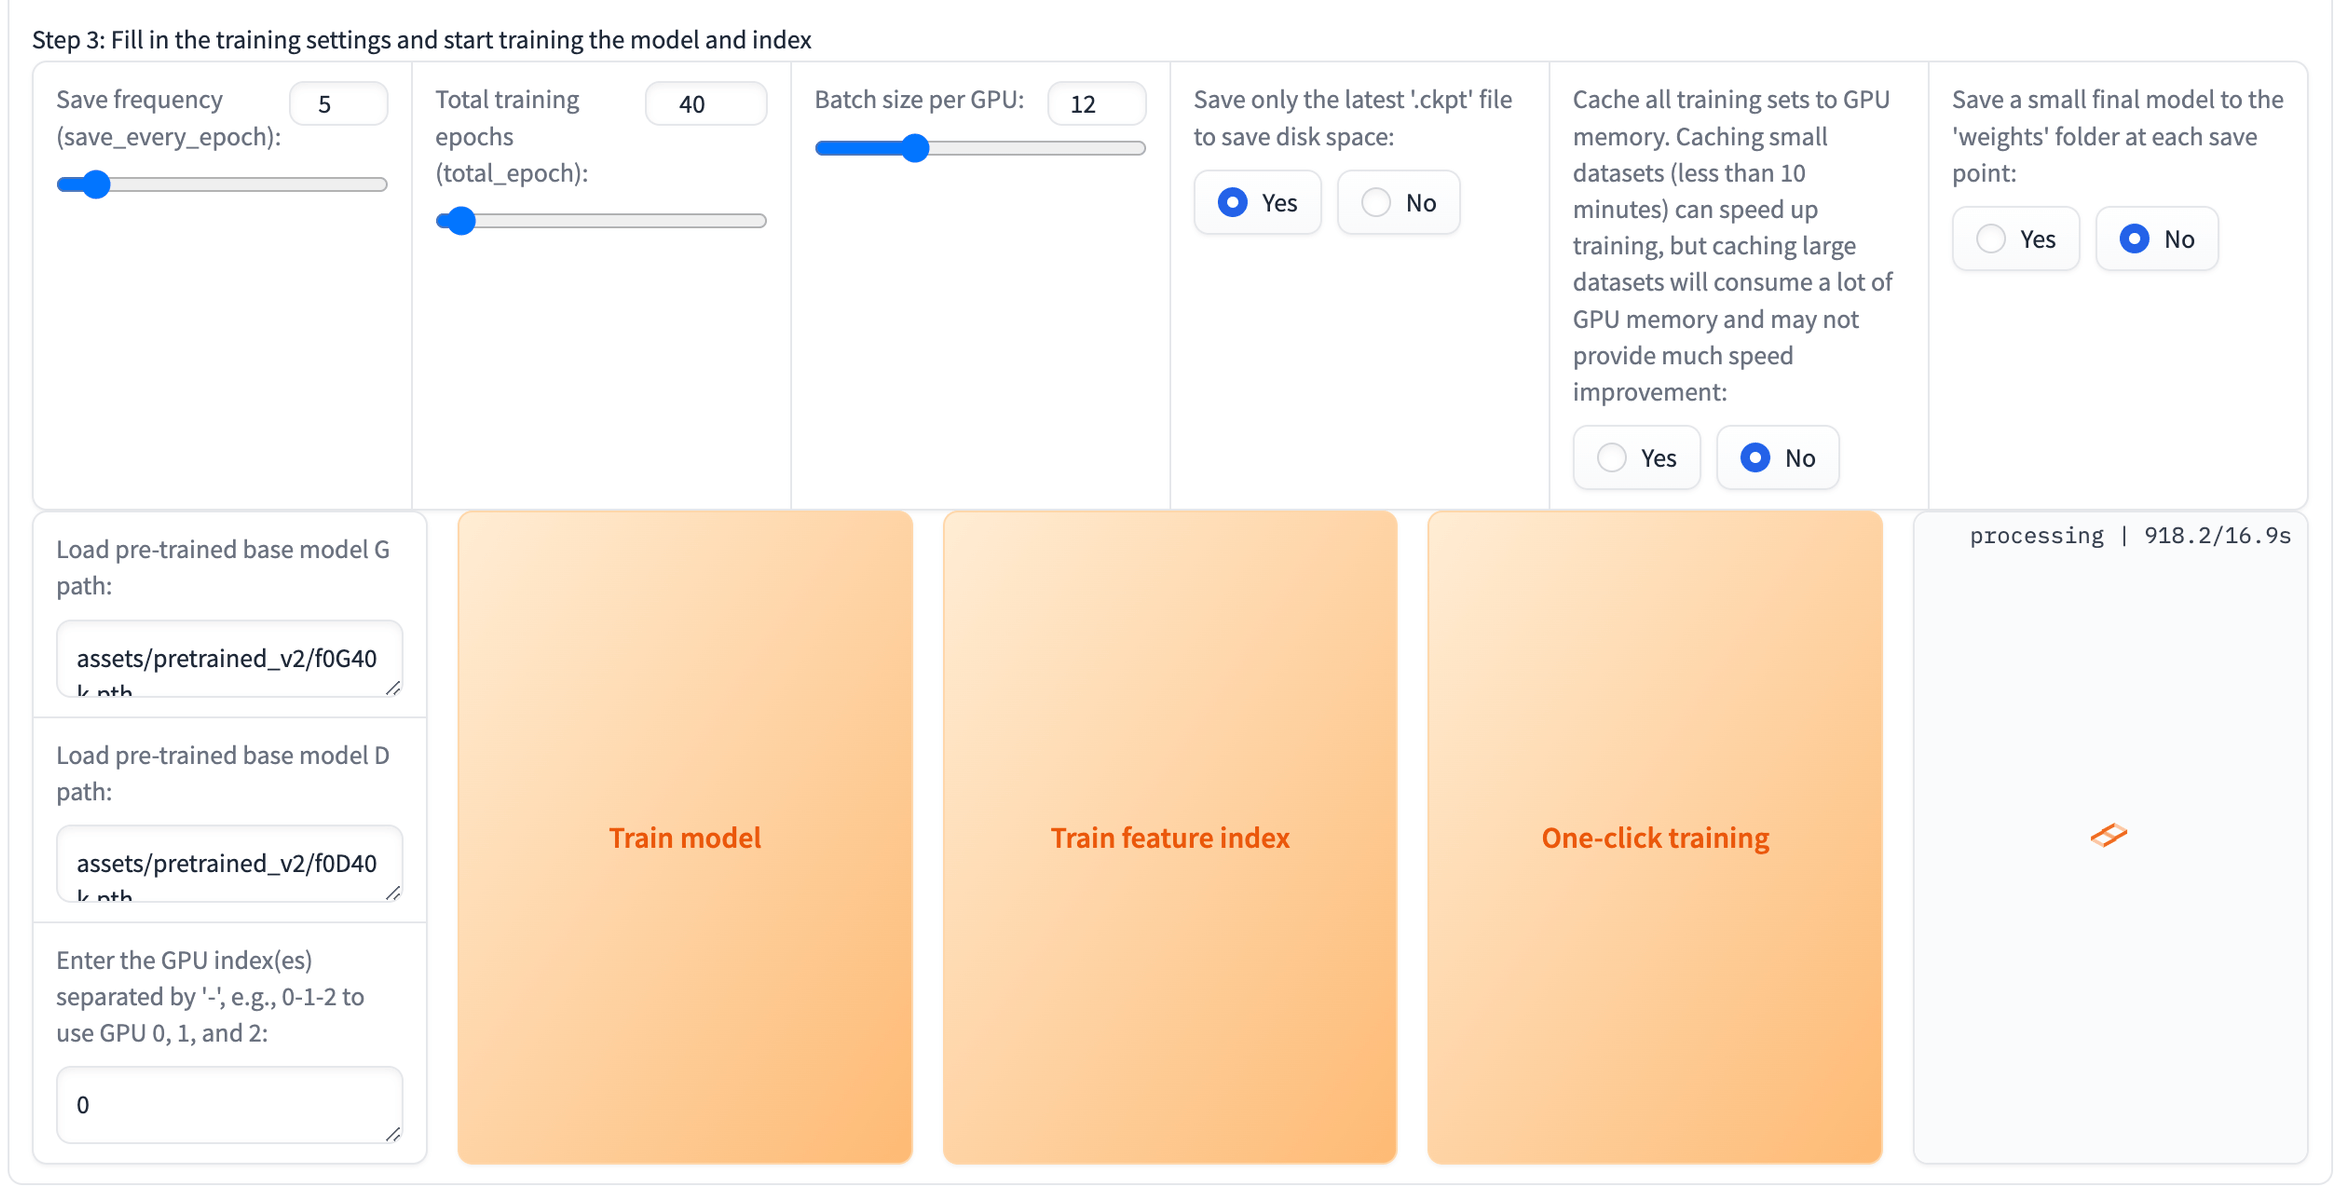
点击 One-click training
5 分离歌声
下载 The Ultimate Vocal Remover Application

使用 UVR-MDX-NET Inst HQ 3 进行人声分离
分离完会生成 2 个文件,2 个文件都要保留
- 1_痛仰乐队 - 我愿意 (Live)_(Vocals).wav:这个是人声文件
- 1_痛仰乐队 - 我愿意 (Live)_(Instrumental).wav:这个是伴奏文件
继续使用 Reverb HQ 对分离出来的人声进行去回声。

生成没有回声的文件:1_1_痛仰乐队 - 我愿意 (Live)_(Vocals)_(No Reverb).wav,一会就要使用这个文件合成歌声
6 推理歌声

下载推理出来个纯人声,放入 Davinci 与刚才的 1_痛仰乐队 - 我愿意 (Live)_(Instrumental).wav 合并音轨就可以了,为了好听,可以再给人声加上回声。